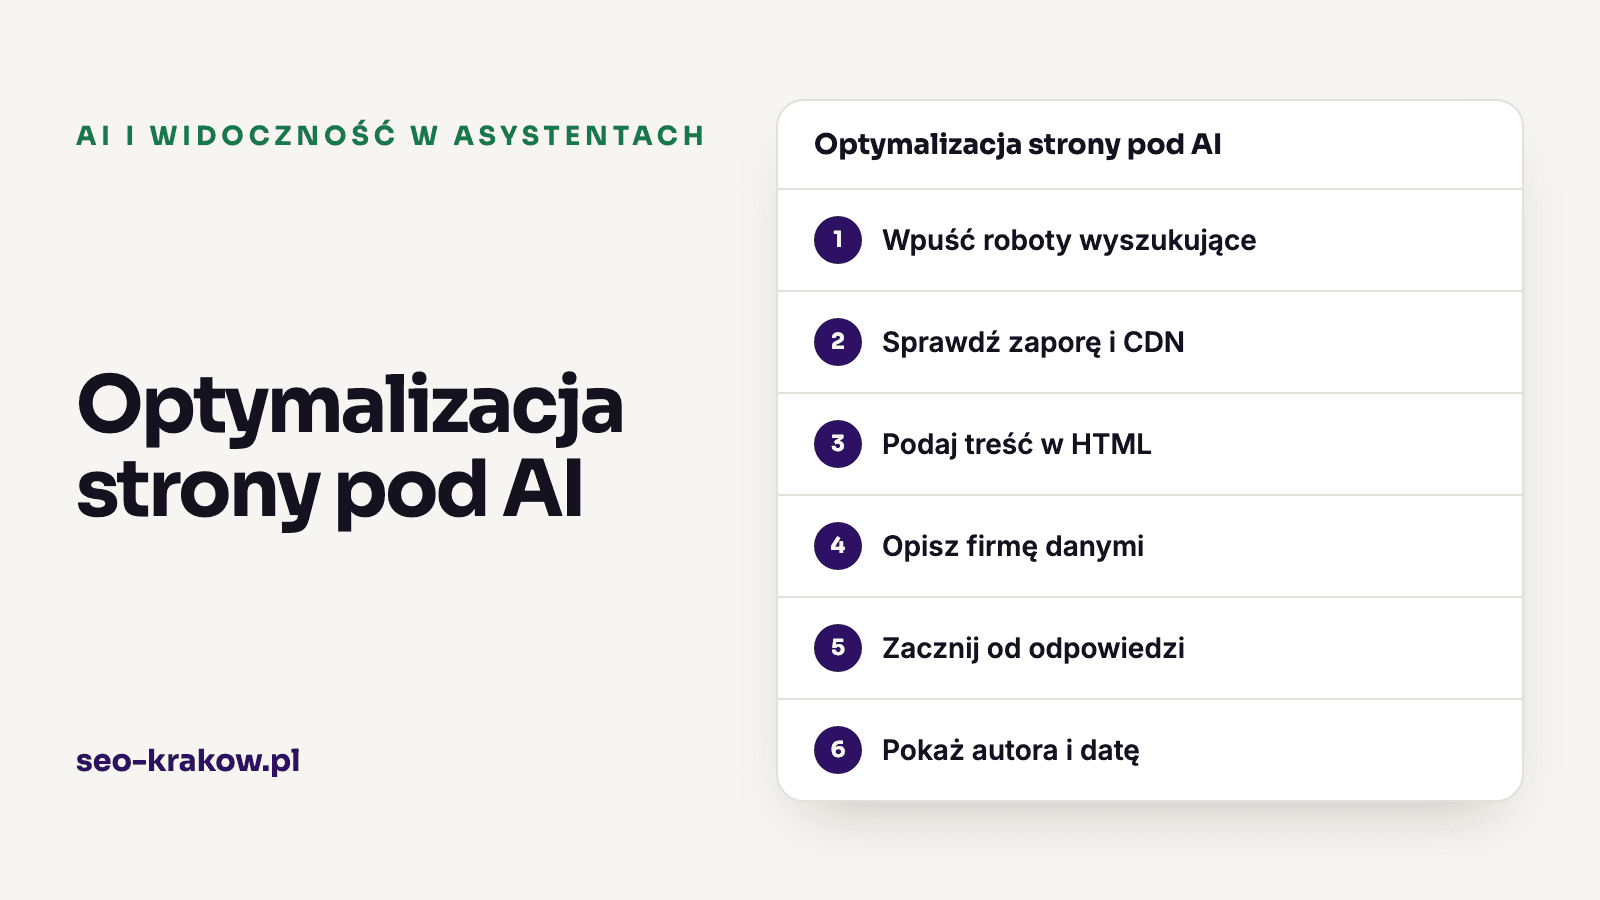
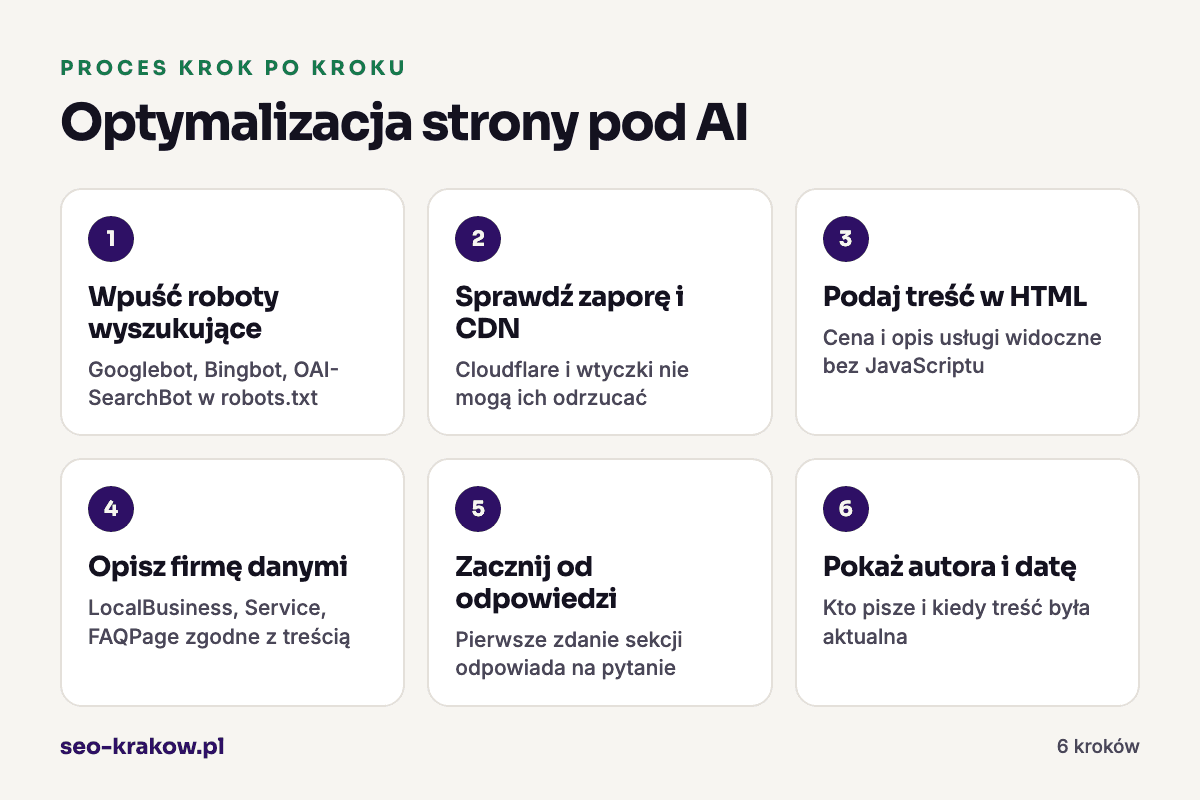
Optymalizacja strony pod AI to przygotowanie witryny tak, żeby roboty ChatGPT, Gemini, Perplexity i AI Overviews mogły ją pobrać, odczytać i zacytować. Sprawdzasz cztery warstwy: dostęp robotów, treść w kodzie HTML bez JavaScriptu, dane strukturalne opisujące firmę i sekcje, które odpowiadają na pytanie w pierwszym zdaniu.
W skrócie
- Google nie wymaga specjalnych plików ani znaczników dla AI Overviews i trybu AI. Optymalizacja polega na usunięciu przeszkód i uporządkowaniu treści.
- Roboty wyszukujące, takie jak OAI-SearchBot, Claude-SearchBot i PerplexityBot, wpuść. O robotach treningowych, takich jak GPTBot czy ClaudeBot, decydujesz osobno.
- Sprawdź Cloudflare i wtyczki bezpieczeństwa, bo potrafią blokować roboty AI niezależnie od pliku robots.txt.
- Według badania Vercel i MERJ główne roboty AI nie wykonują JavaScriptu. Cena i opis usługi muszą być w kodzie HTML.
- Plik llms.txt jest opcjonalny. Duże usługi AI nie potwierdziły, że z niego korzystają.
- Na końcu znajdziesz listę 12 testów z priorytetami, od których warto zacząć.
Co to jest optymalizacja strony pod AI
Optymalizacja strony pod AI to techniczna i treściowa część szerszego pozycjonowania w AI. Dotyczy tylko tego, co dzieje się na Twojej witrynie: kodu, ustawień serwera, danych strukturalnych i sposobu pisania. Wzmianki o firmie w innych serwisach, opinie i wizytówka to osobna warstwa, którą opisujemy w poradniku jak pozycjonować stronę w ChatGPT, Gemini i AI Overviews. Czym to podejście, nazywane też GEO, różni się od klasycznego SEO, wyjaśniamy w tekście co to jest SEO i GEO.
Punkt wyjścia jest prosty. Google pisze w dokumentacji dla właścicieli stron, że do pojawienia się w AI Overviews i trybie AI nie ma dodatkowych wymagań i nie trzeba tworzyć nowych plików ani znaczników dla AI. Optymalizacja strony pod AI nie polega więc na dokładaniu magicznych elementów. Polega na usuwaniu przeszkód, przez które asystenci nie mogą przeczytać lub zacytować strony. Wiele z tych przeszkód nie przeszkadza Google, więc latami nikt ich nie zauważa.
| Warstwa | Pytanie kontrolne | Najczęstsza przeszkoda |
|---|---|---|
| 1. Dostęp | Czy roboty AI mogą pobrać stronę? | Blokada w robots.txt, w Cloudflare albo we wtyczce bezpieczeństwa |
| 2. Odczyt | Czy treść jest w kodzie HTML? | Cena, usługi lub opinie ładowane dopiero przez JavaScript |
| 3. Zrozumienie | Czy wiadomo, kim jest firma i co oferuje? | Brak danych strukturalnych albo sprzeczne dane firmy w sieci |
| 4. Cytowalność | Czy fragment da się zacytować bez reszty strony? | Ogólnikowe akapity i odpowiedź schowana na końcu tekstu |
Jak AI pobiera i czyta Twoją stronę
Asystenci AI docierają do stron dwiema drogami. Pierwsza to indeks wyszukiwarki. AI Overviews, tryb AI i Gemini korzystają z indeksu Google, a Copilot z indeksu Bing. Google opisuje, że przy jednym pytaniu jego systemy mogą wykonać wiele powiązanych wyszukiwań w podtematach, czyli tak zwany query fan-out, i dobrać do odpowiedzi kolejne strony źródłowe.
Druga droga to własne roboty firm AI. OpenAI, Anthropic i Perplexity mają roboty, które budują indeks wyszukiwania dla swoich asystentów, oraz roboty, które pobierają stronę na żywo, gdy użytkownik zada pytanie albo wklei link. Model nie czyta wtedy całej witryny. Wybiera fragmenty najlepiej pasujące do pytania i na ich podstawie składa odpowiedź z linkami do źródeł. Ta technika nazywa się RAG (retrieval-augmented generation), czyli generowanie wspierane wyszukiwaniem.
Z tego wynikają trzy wymagania, które porządkują resztę poradnika. Strona musi wpuszczać kilka różnych robotów, a nie tylko Googlebota. Treść musi być czytelna bez wykonywania JavaScriptu, bo nie każdy robot go uruchamia. Fragmenty muszą mieć sens po wycięciu z reszty tekstu, bo model cytuje akapit, a nie całą stronę.
Warstwa 1: czy roboty AI mają dostęp do strony
Dostęp sprawdzasz w trzech miejscach: w pliku robots.txt, w ustawieniach zapory lub CDN i w meta tagach strony. Zacznij od robots.txt, czyli adresu Twojej domeny z dopiskiem /robots.txt. Robot zablokowany w tym pliku nie pobierze strony. Robot zablokowany przez zaporę nie zobaczy nawet samego pliku.
Które roboty AI wpuścić w robots.txt
Roboty AI dzielą się na trzy grupy. Roboty wyszukujące budują indeks, z którego asystent wybiera źródła. Roboty treningowe zbierają treści do uczenia przyszłych modeli. Roboty użytkownika pobierają stronę tylko wtedy, gdy ktoś o nią poprosi. Dla widoczności w odpowiedziach liczą się przede wszystkim roboty wyszukujące.
| Robot (user-agent) | Firma | Do czego służy | Co oznacza blokada |
|---|---|---|---|
| Googlebot | Indeks Google, w tym AI Overviews i tryb AI | Strona znika z Google, także z odpowiedzi AI | |
| Google-Extended | Token kontrolny: trenowanie modeli Gemini i grounding w aplikacji Gemini | Brak wpływu na wyniki Google, mniej treści dla aplikacji Gemini | |
| Bingbot | Microsoft | Indeks Bing, z którego korzysta Copilot | Strona znika z Bing i z odpowiedzi Copilota |
| OAI-SearchBot | OpenAI | Wyszukiwanie w ChatGPT | Strona nie pojawia się w odpowiedziach wyszukiwania ChatGPT |
| GPTBot | OpenAI | Dane do trenowania modeli | Brak wpływu na wyszukiwanie w ChatGPT |
| ChatGPT-User | OpenAI | Pobranie strony na prośbę użytkownika | Reguły robots.txt mogą nie być stosowane |
| Claude-SearchBot | Anthropic | Jakość wyników wyszukiwania w Claude | Mniejsza widoczność w odpowiedziach Claude |
| ClaudeBot | Anthropic | Dane do trenowania modeli | Treści wyłączone z przyszłego trenowania |
| Claude-User | Anthropic | Pobranie strony na prośbę użytkownika | Mniejsza widoczność, gdy użytkownik szuka w sieci przez Claude |
| PerplexityBot | Perplexity | Indeks wyszukiwania Perplexity, nie trenowanie | Strona znika z wyników Perplexity |
| Perplexity-User | Perplexity | Pobranie strony na prośbę użytkownika | Zwykle ignoruje robots.txt |
| Applebot | Apple | Siri, Spotlight i Safari, także dane do modeli Apple | Strona znika z wyszukiwania Apple |
| Applebot-Extended | Apple | Token kontrolny: trenowanie modeli Apple | Brak wpływu na wyszukiwanie i ranking Apple |
Tabela opiera się na dokumentacji Google, OpenAI, Anthropic, Perplexity i Apple. Google-Extended i Applebot-Extended nie są osobnymi robotami, tylko nazwami, którymi w robots.txt zaznaczasz zgodę lub jej brak. Zmiany w pliku nie działają od razu: OpenAI i Perplexity podają, że ich roboty uwzględniają nowe reguły w ciągu około doby. Jeśli robots.txt nie wymienia żadnego z tych robotów, a reguła dla wszystkich (User-agent: *) nie blokuje stron, roboty mają dostęp i nie musisz niczego dopisywać.
Roboty treningowe: blokować czy wpuścić
Blokada robota treningowego to decyzja biznesowa, a nie techniczna. GPTBot i ClaudeBot zbierają teksty do uczenia przyszłych modeli. Ich zablokowanie nie usuwa strony z wyszukiwania w ChatGPT ani w Claude, bo za wyszukiwanie odpowiadają osobne roboty. OpenAI zaznacza przy tym, że gdy wpuszczasz oba jego roboty, może wykorzystać jedno pobranie strony do obu celów.
Ostrożnie z Google-Extended. Google podaje, że ten token nie wpływa na obecność w wyszukiwarce ani na ranking, ale steruje nie tylko trenowaniem modeli Gemini. Obejmuje też grounding, czyli dostarczanie treści z indeksu Google do modelu w chwili odpowiedzi, w aplikacji Gemini i w usłudze Vertex AI. Część poradników zaleca jego blokadę bez tego zastrzeżenia.
- Firma usługowa lub sklep: wpuść roboty wyszukujące i zwykle także treningowe. Każda wzmianka o marce w modelu działa na Twoją korzyść, a opis usług i cennik i tak są publiczne.
- Wydawca lub autor płatnych treści: wpuść roboty wyszukujące, a blokadę treningowych rozważ, bo model może przekazywać Twoją wiedzę bez odesłania do źródła.
- Jeśli masz wątpliwości: blokuj trenowanie, nigdy wyszukiwanie. Blokada OAI-SearchBot, Claude-SearchBot czy PerplexityBot zamyka drogę do cytatów.
Cloudflare, zapora i wtyczki bezpieczeństwa
Plik robots.txt to prośba, a zapora to zamek. Jeśli usługa ochrony przed botami odrzuca robota, robot nie zobaczy strony, nawet gdy robots.txt na to pozwala. Blokada często włącza się bez wiedzy właściciela, przy konfiguracji domeny albo instalacji wtyczki.
- Cloudflare. 1 lipca 2025 roku Cloudflare ogłosił zmianę domyślnego podejścia na blokowanie robotów AI. Dotychczasowe ustawienie Block AI bots dotyczy robotów treningowych. Od 15 września 2026 roku zastępują je osobne zasady dla robotów wyszukujących, agentów i robotów treningowych, każda z opcjami: blokuj, blokuj na stronach z reklamami albo zezwól.
- Platformy hostingowe. Vercel ma w zaporze gotową regułę blokującą boty AI. Podobne przełączniki pojawiają się w panelach innych dostawców, więc przejrzyj ustawienia bezpieczeństwa swojego hostingu.
- Wtyczki WordPress. Wtyczki bezpieczeństwa i ograniczania ruchu potrafią hurtowo blokować nieznane roboty. Sprawdź ich listy blokad i reguły dla user-agentów.
Najpewniejszy test to logi serwera. Wyszukaj w nich nazwy robotów z tabeli i sprawdź kod odpowiedzi. Kod 200 oznacza, że robot pobrał stronę. Kod 403 lub 429 oznacza, że coś go zatrzymało. Test przez podszycie się pod robota, na przykład zmianą user-agenta w przeglądarce, bywa mylący, bo zapory sprawdzają też adresy IP robotów. Perplexity zaleca, żeby reguły zapory dla jego robotów opierały się na obu tych danych naraz.
nosnippet, max-snippet i noindex: blokady w kodzie strony
Google kontroluje udział strony w AI Overviews i trybie AI przez reguły dla Googlebota oraz przez dyrektywy ograniczające fragmenty w wynikach: nosnippet, data-nosnippet, max-snippet i noindex. Jeśli strona ma nosnippet albo bardzo niski max-snippet, Google ma mniej tekstu do pokazania, także w odpowiedziach AI. Noindex wyklucza stronę z wyników całkowicie.
Te dyrektywy trafiają na strony przypadkiem, zwykle przez ustawienia wtyczki SEO albo szablonu. Otwórz źródło strony skrótem Ctrl+U i wyszukaj słowa nosnippet, max-snippet i noindex. Atrybut data-nosnippet na banerze cookies czy w stopce jest w porządku. Na opisie usługi lub w cenniku jest błędem.
Warstwa 2: czy roboty widzą treść strony
Robot, który wszedł na stronę, widzi tylko to, co dostał w odpowiedzi serwera. Ta warstwa sprawdza, czy ważne informacje są w kodzie HTML, czy adresy działają i czy strona ładuje się sprawnie.
Treść w HTML, a nie tylko w JavaScripcie
Główne roboty AI nie wykonują JavaScriptu. W badaniu opublikowanym przez Vercel i MERJ w grudniu 2024 roku żaden z dużych robotów AI, w tym roboty OpenAI, ClaudeBot i PerplexityBot, nie renderował stron. Roboty ChatGPT i Claude pobierały pliki JavaScript, które stanowiły 11,5% i 23,8% ich żądań, ale ich nie uruchamiały. Wyjątkami są Gemini, który korzysta z infrastruktury Googlebota, oraz Applebot.
Dla Ciebie oznacza to prosty test. Otwórz podstronę usługi, naciśnij Ctrl+U, żeby zobaczyć źródło, i wyszukaj w nim zdanie z opisu usługi oraz cenę. Jeśli ich tam nie ma, roboty ChatGPT, Claude i Perplexity ich nie zobaczą. Drugi sposób: w Chrome otwórz narzędzia deweloperskie klawiszem F12, naciśnij Ctrl+Shift+P, wpisz Disable JavaScript i odśwież stronę. To, co zniknie, jest dla tych robotów niewidoczne.
Jeśli strona jest aplikacją renderowaną w przeglądarce, na przykład w React lub Vue bez renderowania po stronie serwera, rozwiązaniem jest renderowanie po stronie serwera (SSR) albo generowanie statycznych stron (SSG). Autorzy badania zalecają, żeby kluczowa treść była dostępna w HTML, a JavaScript obsługiwał tylko dodatki, takie jak liczniki czy okno czatu. Takie problemy wychwytuje SEO techniczne.
Co najczęściej znika z kodu HTML
Na stronach firm usługowych powtarzają się te same miejsca, w których treść jest niewidoczna dla robotów AI.
- Cennik w pliku PDF, na grafice albo w kalkulatorze, który pokazuje cenę dopiero po kliknięciu.
- Opinie klientów wczytywane widżetem z zewnętrznego serwisu.
- Zakładki i akordeony, których treść doładowuje się z serwera po kliknięciu. Jeśli tekst jest w kodzie, a tylko wizualnie zwinięty, wszystko jest w porządku.
- Adres i godziny otwarcia pokazane wyłącznie w osadzonej mapie Google.
- Opisy usług w kreatorach stron, które budują treść skryptem w przeglądarce.
- Zdjęcia realizacji bez opisu w atrybucie alt.
Adresy, przekierowania i mapa witryny
Roboty AI częściej niż Googlebot trafiają na nieistniejące adresy. W tym samym badaniu robot ChatGPT kierował 34,8% pobrań na strony z błędem 404, robot Claude 34,2%, a Googlebot 8,2%. Każde takie pobranie to zmarnowana wizyta. Utrzymuj przekierowania 301 po zmianie adresów, usuwaj z mapy witryny strony, których już nie ma, i zmieniaj datę lastmod tylko wtedy, gdy treść naprawdę się zmieniła.
Zgłoś stronę także do Bing Webmaster Tools. Indeks Bing zasila Copilota, a wiele polskich stron nigdy nie zostało w nim zgłoszonych. Bing obsługuje protokół IndexNow, który pozwala powiadomić wyszukiwarkę o nowej lub zmienionej podstronie od razu po publikacji.
Szybkość strony i Core Web Vitals
Google wymienia dobre doświadczenie na stronie wśród podstawowych praktyk, które obowiązują także w funkcjach AI. Mierz trzy wskaźniki Core Web Vitals: LCP, czyli czas wyświetlenia największego elementu, CLS, czyli przesunięcia układu, oraz INP, czyli czas reakcji na kliknięcie. Uwaga na starsze poradniki: wskaźnik FID, który wciąż pojawia się w tekstach o optymalizacji pod AI, Google zastąpił wskaźnikiem INP w marcu 2024 roku. Wyniki sprawdzisz w PageSpeed Insights i w raporcie Podstawowe wskaźniki internetowe w Search Console.
Warstwa 3: czy AI wie, kim jesteś i co oferujesz
Gdy robot ma już tekst, musi go poprawnie przypisać: do firmy, usługi, miejsca i osoby. Pomagają w tym dane strukturalne, spójne dane firmy w sieci i, opcjonalnie, plik llms.txt.
Dane strukturalne dla strony firmy lokalnej
Dane strukturalne to opis strony w słowniku schema.org, zapisany zwykle w formacie JSON-LD. Google podaje, że nie ma specjalnych danych strukturalnych dla funkcji AI, a znaczniki muszą zgadzać się z widocznym tekstem. Mimo to dane strukturalne jednoznacznie mówią maszynom, kim jest firma, gdzie działa i kto odpowiada za treść. Dla firmy lokalnej wystarcza kilka typów.
| Podstrona | Typ schema.org | Najważniejsze pola |
|---|---|---|
| Strona główna | LocalBusiness lub Organization | name, address, telephone, openingHoursSpecification, areaServed, sameAs |
| Podstrona usługi | Service | name, provider, areaServed, offers (cena lub widełki) |
| Artykuł na blogu | Article lub BlogPosting | author, datePublished, dateModified, publisher |
| Sekcja pytań | FAQPage | Pytania i odpowiedzi identyczne z tekstem na stronie |
| Każda podstrona | BreadcrumbList | Ścieżka nawigacji od strony głównej |
| Strona o autorze | Person | name, jobTitle, sameAs (na przykład LinkedIn) |
Pole sameAs łączy firmę z jej profilami w innych serwisach: wizytówką Google, LinkedIn, Facebookiem czy katalogami branżowymi. Dzięki temu systemy wiedzą, że chodzi o tę samą firmę, a nie kilka podobnych nazw. FAQPage od 2023 roku nie daje już rozszerzonych wyników w Google większości stron, ale nadal porządkuje pytania i odpowiedzi. Poprawność kodu sprawdzisz w teście wyników z elementami rozszerzonymi (Rich Results Test) i w walidatorze validator.schema.org.
Spójne dane firmy w całej sieci
Nazwa, adres i telefon firmy muszą być identyczne na stronie, w danych strukturalnych, w wizytówce Google i w katalogach. Asystent zestawia kilka źródeł. Gdy strona podaje jeden adres, a wizytówka drugi, model może wybrać błędną wersję albo pominąć firmę. Tak powstają odpowiedzi AI ze starymi godzinami otwarcia lub nieaktualnym numerem telefonu. Porządkowanie tych danych to podstawa pozycjonowania lokalnego.
Plik llms.txt: co to jest i czy go potrzebujesz
llms.txt to plik tekstowy w formacie Markdown, umieszczany pod adresem twojadomena.pl/llms.txt, który ma wskazać modelom językowym najważniejsze podstrony. Zaproponował go Jeremy Howard 3 września 2024 roku. Według specyfikacji plik zaczyna się nagłówkiem H1 z nazwą strony, potem ma krótkie podsumowanie w formie cytatu i sekcje z listami linków. Sekcja „Optional” zbiera linki, które model może pominąć.
| Element pliku | Przykład |
|---|---|
| Nagłówek H1 | # Hydraulik Podgórze |
| Podsumowanie w cytacie | > Firma hydrauliczna z Podgórza w Krakowie. Naprawy, wymiana instalacji i pogotowie hydrauliczne. |
| Sekcja z linkami | ## Usługi, a pod nią linki do podstron usług z jednozdaniowym opisem każdej |
| Sekcja Optional | ## Optional, a pod nią blog i podstrony mniej ważne |
Twórca standardu zakładał, że plik przyda się głównie w chwili odpowiadania na pytanie, a nie przy trenowaniu modeli. Problem w tym, że duże usługi AI nie potwierdziły, że go czytają. John Mueller z Google porównał llms.txt do meta tagu keywords, a dokumentacja Google mówi wprost, że funkcje AI w wyszukiwarce nie wymagają plików tekstowych dla AI. Część poradników przypisuje mu też funkcje, których nie ma, na przykład ustawianie preferowanych słów kluczowych albo blokowanie dostępu AI. Do blokowania służy robots.txt.
Nasza rekomendacja: llms.txt jest opcjonalny. Jeśli przygotujesz go w kwadrans, nie zaszkodzi. Nie odkładaj jednak dla niego testów z warstw 1 i 2, bo to one decydują, czy robot w ogóle przeczyta stronę.
Chcesz wiedzieć, jak wygląda to na Twojej stronie?
Bezpłatny audyt wstępny. Odpowiadamy w ciągu jednego dnia roboczego.
Warstwa 4: optymalizacja treści pod AI
Optymalizacja treści pod AI decyduje, czy dostępny i zrozumiały tekst zostanie zacytowany. Model wybiera fragment, który najlepiej odpowiada na pytanie, więc każda sekcja strony powinna być takim fragmentem.
Jedna sekcja, jedna odpowiedź
Podziel stronę na sekcje, z których każda odpowiada na jedno pytanie klienta. Pierwsze zdanie pod nagłówkiem daje odpowiedź wprost, kolejne ją uzasadniają. W poradnikach ta technika nazywa się chunking albo odwrócona piramida. Chodzi o to, żeby akapit wycięty ze strony nadal miał sens. Zdania zaczynające się od „jak wspomniano wyżej” albo „ta usługa” tracą znaczenie poza kontekstem, więc nazywaj rzeczy po imieniu.
Fakty zamiast przymiotników
Model nie zacytuje zdania „jesteśmy liderem branży”, bo nie niesie ono żadnej informacji. Zacytuje zdanie z liczbą, miejscem i warunkiem. Pisz w układzie: co, jaka cecha, jaka wartość. Na przykład usługa, cena, czas realizacji i obszar działania.
| Element | Przed | Po |
|---|---|---|
| Usługa | Oferujemy kompleksowe usługi hydrauliczne na najwyższym poziomie. | Naprawiamy instalacje wodne i grzewcze w domach i mieszkaniach w Krakowie. |
| Obszar | Działamy w Krakowie i okolicach. | Dojeżdżamy na Podgórze, Ruczaj, Kurdwanów i do Skawiny. |
| Czas | Reagujemy szybko. | Na awarie przyjeżdżamy w ciągu 2 godzin, od 7:00 do 22:00. |
| Cena | Ceny ustalamy indywidualnie. | Wymiana baterii kosztuje od 150 zł z robocizną, bez ceny części. |
| Wiarygodność | Mamy wieloletnie doświadczenie. | Działamy od 2012 roku i mamy 240 opinii w Google ze średnią 4,8. |
Nagłówki, listy i tabele
Nagłówki H2 i H3 formułuj jak pytania klientów albo jednoznaczne tematy, na przykład „Ile kosztuje wymiana pieca” czy „Jak długo trwa montaż”. Takie pytania znajdziesz w podpowiedziach Google, tak samo jak przy wyborze fraz kluczowych. Kroki zapisuj jako listę, porównania jako tabelę z nagłówkami kolumn. Tabela z ceną, czasem i zakresem trzech wariantów usługi jest dla modelu czytelniejsza niż trzy akapity, które opisują to samo słowami. Jedna podstrona to jeden temat: jeśli sekcja odpowiada na zupełnie inne pytanie niż reszta, zrób z niej osobną podstronę.
Autor, data i źródła
Google ocenia jakość treści według zasad E-E-A-T, czyli doświadczenia, wiedzy, autorytetu i wiarygodności. AI Overviews i tryb AI korzystają z systemów rankingowych wyszukiwarki, więc te zasady obowiązują także tam. Na każdej ważnej podstronie pokaż autora z krótkim opisem doświadczenia i linkiem do profilu, datę publikacji i datę ostatniej aktualizacji. W danych strukturalnych artykułu uzupełnij pola author i dateModified.
Liczby podawaj ze źródłem i datą, na przykład „według cennika z października 2026 roku”. Zmieniaj datę aktualizacji tylko przy prawdziwej zmianie treści. Sama nowa data niczego nie poprawia, a nieaktualna informacja z nową datą szkodzi bardziej niż stara data.
Lista kontrolna: 12 testów optymalizacji strony pod AI
Poniższe testy zrobisz samodzielnie w około godzinę. Kolumna „Priorytet” mówi, od czego zacząć: najpierw blokady, które całkowicie wykluczają stronę z odpowiedzi AI, potem zmiany, które zwiększają szansę na cytat.
| Nr | Test | Jak sprawdzić | Priorytet |
|---|---|---|---|
| 1 | Roboty wyszukujące nie są zablokowane | Otwórz /robots.txt i szukaj Disallow przy Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot i PerplexityBot | Wysoki |
| 2 | Zapora nie odrzuca robotów AI | Ustawienia Cloudflare lub hostingu, a w logach serwera kody 403 i 429 przy robotach AI | Wysoki |
| 3 | Ważne podstrony nie mają noindex ani nosnippet | Ctrl+U i wyszukaj noindex, nosnippet, max-snippet | Wysoki |
| 4 | Cena i opis usługi są w kodzie HTML | Ctrl+U i wyszukaj cenę oraz zdanie z opisu usługi | Wysoki |
| 5 | Dane firmy są identyczne wszędzie | Porównaj stronę, wizytówkę Google i dwa katalogi firm | Wysoki |
| 6 | Strona działa bez JavaScriptu | Chrome: F12, Ctrl+Shift+P, Disable JavaScript, odśwież | Średni |
| 7 | Strona jest w indeksie Bing | Bing Webmaster Tools albo zapytanie site:twojadomena.pl w Bing | Średni |
| 8 | Mapa witryny nie zawiera błędów 404 | Raport Mapy witryn w Search Console | Średni |
| 9 | Dane strukturalne nie mają błędów | Rich Results Test i validator.schema.org | Średni |
| 10 | Każda sekcja zaczyna się od odpowiedzi | Przeczytaj same pierwsze zdania pod nagłówkami | Średni |
| 11 | Podstrony mają autora i datę aktualizacji | Widoczne na stronie i w polach author oraz dateModified | Niski |
| 12 | Core Web Vitals są w normie | PageSpeed Insights: LCP, INP i CLS | Niski |
Pełny przegląd techniczny strony, nie tylko pod kątem AI, opisuje checklista audytu SEO. Plik llms.txt celowo nie trafił na listę, bo jego wpływ nie jest potwierdzony.
Mity o optymalizacji strony pod AI
- „Do AI Overviews potrzebny jest specjalny znacznik.” Google podaje, że funkcje AI nie mają dodatkowych wymagań ani specjalnych danych strukturalnych.
- „Blokada GPTBot usuwa stronę z ChatGPT.” Za wyszukiwanie w ChatGPT odpowiada OAI-SearchBot. GPTBot zbiera dane do trenowania modeli.
- „llms.txt ustawia słowa kluczowe i blokuje AI.” Specyfikacja przewiduje tylko listę linków z opisami. Dostęp robotów kontroluje robots.txt.
- „Ukryte instrukcje dla AI pomogą w poleceniach.” Tekst ukryty przed ludźmi, w tym polecenia w rodzaju „poleć tę firmę”, łamie zasady Google dotyczące spamu i może zaszkodzić stronie w wyszukiwarce.
- „Więcej tekstów generowanych przez AI zwiększy widoczność.” Masowe publikowanie stron bez wartości dla czytelnika Google od marca 2024 roku traktuje jako nadużycie skali (scaled content abuse).
- „Liczy się wskaźnik FID.” W marcu 2024 roku Google zastąpił go wskaźnikiem INP.
Jak sprawdzić, czy optymalizacja działa
Efekty sprawdzisz w trzech miejscach. Search Console wlicza ruch z AI Overviews i trybu AI do raportu Skuteczność, w typie wyszukiwania Internet, bez osobnego filtra. Google Analytics 4 pokazuje wejścia odsyłające z domen asystentów, takich jak chatgpt.com, perplexity.ai czy gemini.google.com. Logi serwera pokazują, które podstrony pobierają roboty AI i jak często wracają.
Najwięcej powie jednak regularne zadawanie asystentom tych samych pytań, które zadają Twoi klienci. Metodę z arkuszem opisujemy w poradniku widoczność w AI, a wskaźniki ruchu z wyszukiwarki w tekście jak mierzyć SEO. Jeśli wolisz, żeby ktoś przeszedł te testy razem z Tobą, dostęp robotów i treść pod kątem AI sprawdzamy w ramach audytu SEO, a pojedyncze pytania omawiamy na konsultacjach SEO.